분리쏙 개발기
들어가며
분리배출은 생각보다 자주 틀립니다. 게다가 기준은 지자체 조례마다 조금씩 달라서 이사를 하면 원래 알던 방법이 맞지 않을 수 있습니다. 기존 서비스들은 품목 이름을 알아야 검색할 수 있거나 지자체별 기준을 반영하지 않았습니다. 범용 LLM에 물어보면 그럴듯하지만 틀린 답이 나올 수 있습니다.
분리쏙은 사진 한 장으로 품목을 인식하고 사용자가 사는 지역의 규정을 근거로 배출 방법을 안내하는 서비스입니다. ESTsoft AI Challengers OJT에서 4명이 한 달 동안 만들었고 지원 지역은 서울특별시와 경기도입니다.
저는 LangGraph 에이전트와 RAG를 맡았고 프론트엔드 연동 일부를 함께 했습니다. 이 글은 제가 맡은 부분이 어떻게 바뀌어 왔는지에 대한 기록입니다.
전체 흐름
촬영 (React, GrabCut으로 구도 안내)
  → YOLO 품목 분류 (17개 클래스)
  → LangGraph 에이전트 (분기 · 재분류)
  → Pinecone 규정 검색 (전국 기준 + 지역 예외)
  → 출처가 붙은 배출 방법 안내
  → 후속 질문 챗봇
이미지 분류 모델은 팀원들이 맡았고 저는 분류 결과를 받은 뒤부터를 맡았습니다.
데이터: 전국 기준 위에 지역 예외만 얹기
지자체 규정을 문서째로 벡터 DB에 넣으면 같은 내용이 지역마다 반복되고 검색할 때 다른 지역 규정이 섞여 나옵니다. 규정을 읽어 보니 대부분은 환경부 지침을 그대로 따르고 지자체마다 다른 부분은 일부 예외에 그쳤습니다.
그래서 데이터를 두 층으로 나눴습니다.
전국 공통 기준 위에 시군별 예외만 얹었습니다
| 층 | 출처 | 저장 방식 |
|---|---|---|
| Baseline (전국 공통) | 기후에너지환경부 분리배출 가이드라인 + 별표 1 | 품목 83개, 예외가 없으면 이 기준을 따름 |
| Delta (지역 예외) | 경기도 23개 시군의 분리배출 규정 | 상위 지침과 다른 항목만 53개 레코드로 저장 |
두 데이터는 같은 Pinecone 인덱스에 넣고 doc_type(national_law / region_exception)과 region, major_category, minor_category 같은 메타데이터로 구분했습니다. 검색하기 전에 메타데이터로 먼저 거르기 때문에 다른 지역 규정이 섞이지 않습니다.
적재하면서 막혔던 점도 하나 있었습니다. Pinecone은 메타데이터 값으로 null을 허용하지 않아서 값이 없는 필드는 적재 전에 지우도록 했습니다.
def clean_metadata(metadata: dict) -> dict:
    return {k: v for k, v in metadata.items() if v is not None}
에이전트 구조의 변화
v1. confidence로 나누고 RAG로 답변을 생성하기
처음 구조는 분류 모델의 confidence로 경로를 나눴습니다.
- confidence_router: confidence에 따라 분기
- rule_node: 분류가 확실하면 규칙 기반으로 답변
- classify_node: 애매하면 LLM이 이미지를 보고 다시 분류
- rag_node: 검색한 규정으로 LLM이 자연어 답변을 생성
v1 구조. 애매하면 LLM이 다시 분류하고 답변도 LLM이 생성했습니다
rag_node는 retrieve → generate → judge 서브그래프로 만들었습니다. 생성한 답변을 judge가 검증하고 통과하지 못하면 generate만 다시 실행하는 구조였습니다.
sub_graph_builder.add_edge('retrieve', 'generate')
sub_graph_builder.add_edge('generate', 'judge')
sub_graph_builder.add_conditional_edges("judge", route_after_judge, {
    "retry": "generate",
    "end": END,
})
문제: 애매하면 전부 LLM으로, 틀리면 틀린 채로
만들고 보니 두 가지 문제가 있었습니다.
- 임계값에 너무 많이 기댔습니다. 애매한 구간은 전부 LLM으로 넘어갔고 분류 모델이 자신 있게 틀리면 틀린 결과가 그대로 확정됐습니다.
- 생성 단계가 환각의 원인이었습니다. 근거를 검색해 줘도 LLM은 규정에 없는 내용을 덧붙이곤 했습니다. judge로 걸러낼 수는 있었지만 그만큼 LLM 호출이 늘었습니다.
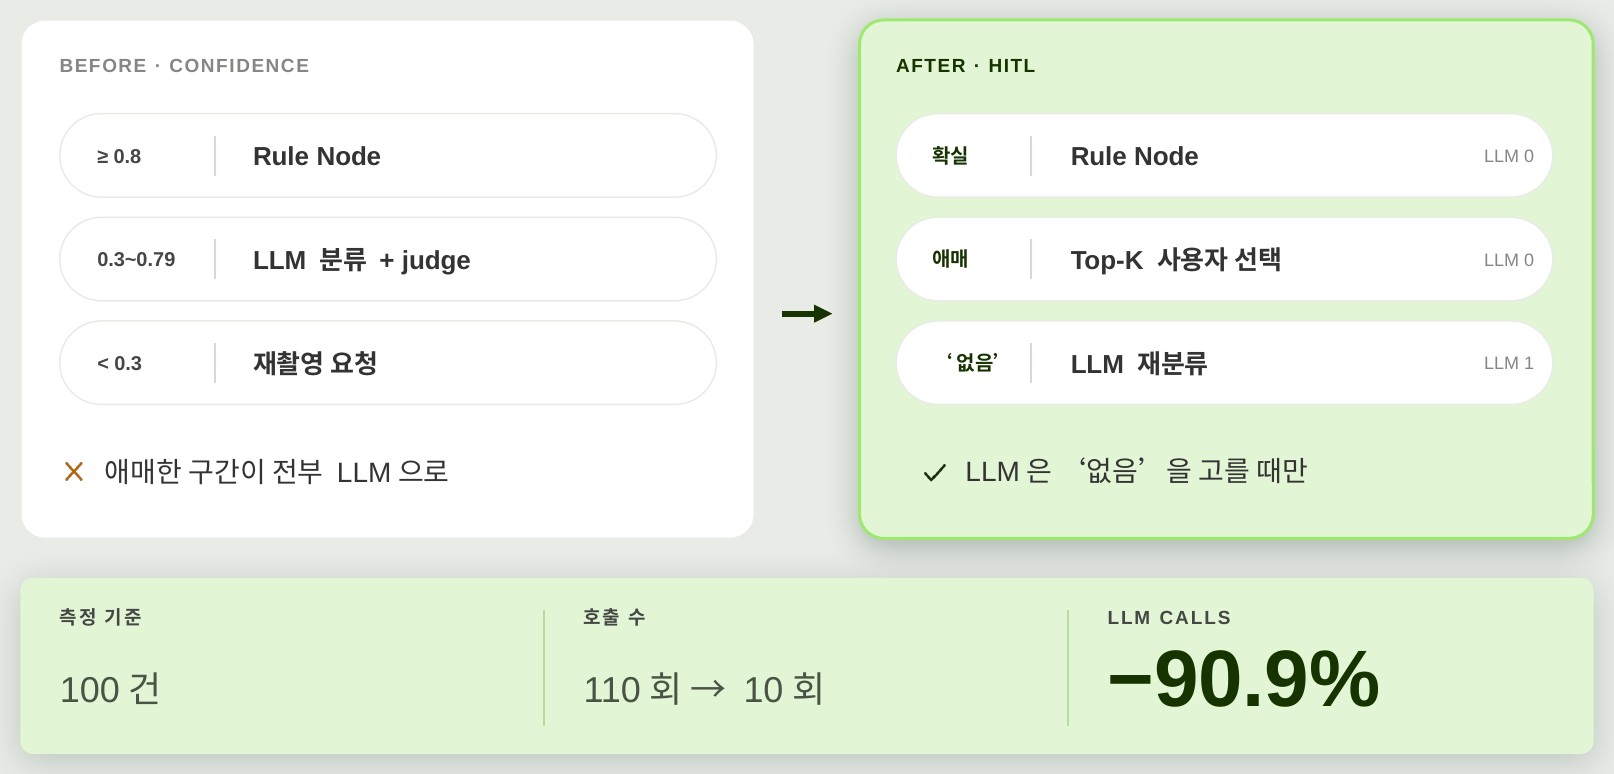
왼쪽이 confidence 분기, 오른쪽이 HITL 구조입니다. LLM은 사용자가 "없음"을 고를 때만 호출됩니다
v2. 사용자에게 먼저 묻고 생성은 없애기
그래서 두 가지를 바꿨습니다.
첫째, 판단의 일부를 사용자에게 넘겼습니다(Human-in-the-loop). 분류가 애매하면 Top-K 후보를 사용자에게 먼저 보여줍니다. 사진 속 물건이 무엇인지는 사용자가 가장 잘 압니다. 후보 중에 맞는 것이 있으면 LLM 없이 바로 진행하고 "여기에 없음"을 고를 때만 LLM이 다시 분류합니다.
둘째, 답변을 생성하지 않고 규정 원문을 돌려주도록 했습니다. disposal_lookup 노드는 LLM 없이 전국 기준과 지역 예외를 검색해 원문 그대로 병합합니다. 규정에 없는 내용이 끼어들 여지가 처음부터 없습니다.
def disposal_lookup_node(state: AgentState) -> dict:
    national_rule = find_national_rule(major_category, minor_category)
    region_rule = find_region_rule(major_category, minor_category, user_region)
    ...
    return {"disposal_result": {
        "national_rule": national_rule,
        "region_rule": region_rule,
        "has_region_exception": region_rule is not None,
    }}
그 결과 confidence_router, rule_node, rag_node 서브그래프는 모두 지웠습니다. 며칠 걸려 만든 코드를 지우는 게 아까웠지만 없어도 되는 노드였습니다.
최종 구조
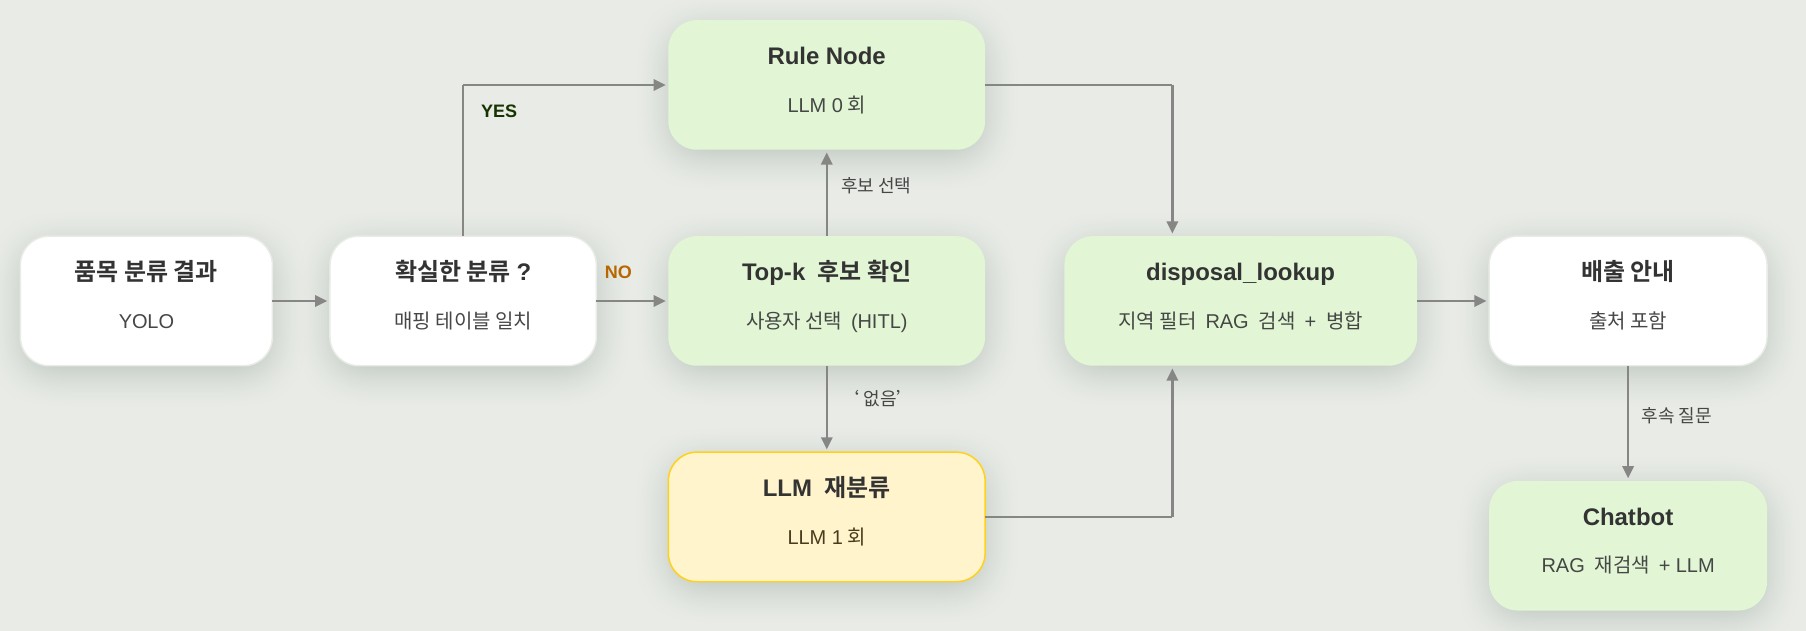
판단은 규칙과 사용자가 하고 근거는 RAG가 가져옵니다
분류가 끝난 경우는 그래프를 거치지 않고 disposal_lookup을 바로 호출합니다. LangGraph 그래프는 "여기에 없음" 흐름에만 씁니다.
설계 포인트
메타데이터 필터링: 검색하기 전에 범위부터 좁히기
지역 예외 53개는 23개 시군에서 모은 것이라 내용이 서로 비슷합니다. 예를 들어 종이팩을 모아 오면 무언가로 바꿔 주는 제도는 여러 시에 있지만 조건이 다릅니다.
| 지역 | 종이팩 교환 조건 |
|---|---|
| 화성시 | 0.5kg → 화장지 1롤 |
| 수원시 | 1kg → 화장지 1롤 + 종량제봉투 10L 1장 |
| 군포시 | 0.5kg → 종량제봉투 10L 1장 |
문장은 거의 같아서 임베딩 유사도만으로 검색하면 수원시 사용자에게 화성시 조건이 나올 수 있습니다. 분리배출 안내에서 다른 지역 규정을 보여주는 것은 틀린 답과 같습니다.
그래서 모든 레코드에 메타데이터를 붙이고 유사도 검색 전에 메타데이터로 먼저 걸렀습니다.
수원시 사용자가 종이류를 찍으면 수원시 종이류 예외만 남기고 그 안에서 고릅니다
지역 예외 레코드는 다음과 같습니다.
{
  "page_content": "유리병 뚜껑은 분리 후 고철류로 배출. 공병 반환금 표기 유리병류는 ...",
  "metadata": {
    "doc_type": "region_exception",
    "region": "양주시",
    "major_category": "유리병",
    "minor_category": "음료수병",
    "material": "유리",
    "exception_type": "처리방식 차이",
    "source": "양주시청 홈페이지",
    "source_url": "https://www.yangju.go.kr"
  }
}
필터는 검색 대상에 따라 다르게 걸었습니다.
| 검색 대상 | 필터 | 목적 |
|---|---|---|
| 전국 기준 | doc_type, major_category, minor_category | 지역 예외가 섞이지 않게 전국 기준만 검색 |
| 지역 예외 | doc_type, region, major_category | 사용자가 설정한 시군의 예외만 검색 |
region에는 사용자가 설정한 시군 이름이 들어갑니다. 지역 예외 데이터는 경기도만 있어서 사용자 지역이 경기도가 아니면 검색하지 않고 바로 건너뜁니다.
def find_region_rule(major_category, minor_category, user_region):
    if user_region.get("sido_name") != "경기도":
        return None

    results = vs.similarity_search(query=minor_category, k=10, filter={
        "doc_type": "region_exception",
        "major_category": major_category,
        "region": user_region.get("sgg_name"),
    })
    if not results:
        return None

    exact = [d for d in results if d.metadata.get("minor_category") == minor_category]
    broad = [d for d in results if "minor_category" not in d.metadata]
    doc = (exact or broad or results)[0]
지역 예외는 소분류를 필터에 넣지 않고 대분류까지만 거른 뒤 코드에서 우선순위를 정했습니다. 어떤 예외는 "음료수병"처럼 특정 품목에만 적용되고 어떤 예외는 유리병 전체에 적용되기 때문입니다.
- 소분류가 정확히 일치하는 예외
- 대분류 전체에 적용되는 예외 (소분류가 없는 레코드)
- 둘 다 없으면 필터 범위 안에서 의미가 가장 가까운 예외
2번은 앞에서 본 null 처리 덕분에 쉽게 구분할 수 있었습니다. 값이 없는 필드는 적재할 때 지웠기 때문에 minor_category 키가 없는 레코드가 곧 대분류 전체에 적용되는 예외입니다.
필터를 건 뒤로는 다른 지역 규정이 섞여 나오는 문제가 사라졌습니다. 유사도 검색은 필터로 좁힌 범위 안에서만 동작하므로 틀린 지역을 고를 수가 없습니다.
분류기 클래스와 규정 품목이 딱 맞지 않을 때
YOLO의 세부 클래스와 규정 데이터의 품목은 나누는 기준이 달랐습니다. 예를 들어 분류기는 박카스병, 맥주병, 소주병을 따로 구분하지만 규정 데이터에는 "음료수병" 하나만 있습니다.
그래서 검색을 두 단계로 했습니다. 먼저 소분류까지 정확히 일치하는 항목을 찾고 없으면 같은 대분류 안에서 의미가 가장 가까운 항목으로 대체합니다. 메타데이터 필터로 범위를 좁힌 뒤 그 안에서 임베딩 유사도를 쓰는 방식입니다.
results = vs.similarity_search(query=minor_category, k=1, filter={
    "doc_type": "national_law",
    "major_category": major_category,
    "minor_category": minor_category,
})
if not results:
    # 같은 대분류 안에서 의미상 가장 가까운 항목으로 폴백
    results = vs.similarity_search(query=minor_category, k=1, filter={
        "doc_type": "national_law",
        "major_category": major_category,
    })
LLM 재분류: 정해진 분류 체계 안에서만 답하기
LLM이 "여기에 없음" 이미지를 다시 분류할 때 자유롭게 이름을 지어내면 그 뒤의 규정 검색이 실패합니다. 그래서 프롬프트에 분류 체계를 그대로 넣고 그 안의 표현만 쓰도록 했습니다. 출력은 with_structured_output과 Pydantic 모델로 major_category와 minor_category만 받습니다.
judge와 재시도 루프
재분류 결과가 이미지와 실제로 맞는지 검증하는 judge 노드도 만들었습니다. 맞지 않으면 그 이유를 failure_reason에 담아 classify 프롬프트에 넣고 다시 분류합니다. 무한 루프를 막기 위해 retry_count를 상태로 관리하고 2번을 넘기면 재촬영을 요청합니다.
def route_after_judge(state: AgentState) -> str:
    if state.get("is_valid"):
        return "disposal_lookup"
    if state.get("retry_count", 0) >= MAX_CLASSIFY_RETRIES:
        return "request_retake"
    return "classify"
다만 지금은 이 루프를 그래프에서 연결하지 않고 classify → disposal_lookup으로 바로 이어 두었습니다. 무료 버전 API를 쓰고 있어 호출 한 번에 걸리는 시간이 길었고 judge와 재시도까지 더하면 사용자가 결과를 받기까지 너무 오래 기다려야 했기 때문입니다. 유료 API로 바꾸거나 응답 속도를 확보한 뒤 다시 연결할 계획입니다.
후속 질문 챗봇
배출 방법을 본 뒤 "택배 상자에 붙은 테이프도 떼야 하나요?" 같은 질문이 생길 수 있습니다. 챗봇은 판정된 품목의 전국 기준과 지역 예외를 다시 검색해 문맥으로 넣고 그 안에서 답하도록 했습니다. 답변에는 근거가 된 규정을 함께 보여줍니다.
결과: 예상 LLM 호출 수 비교
확실한 분류가 90%, 애매한 분류가 10%라고 가정하고 100건을 기준으로 비교했습니다.
| 케이스 | v1 (confidence 분기) | v2 (HITL) |
|---|---|---|
| 확실 (90건) | 규정 답변 생성 1회씩 | 0회 |
| 애매 (10건) | 재분류 + 답변 생성 2회씩 | 1회 ("없음" 선택 시) |
| 합계 | 110회 | 10회 (−90.9%) |
비용으로는 약 93.9%가 줄었습니다. 호출 수보다 비용이 더 크게 줄어든 이유는 없앤 호출이 출력 토큰을 많이 쓰는 생성 작업이었기 때문입니다. 출력 토큰 단가는 입력보다 훨씬 비쌉니다.
90:10 비율과 토큰 수는 가정값입니다. 후속 질문 챗봇은 두 구조에서 같아서 비교에서 뺐습니다.
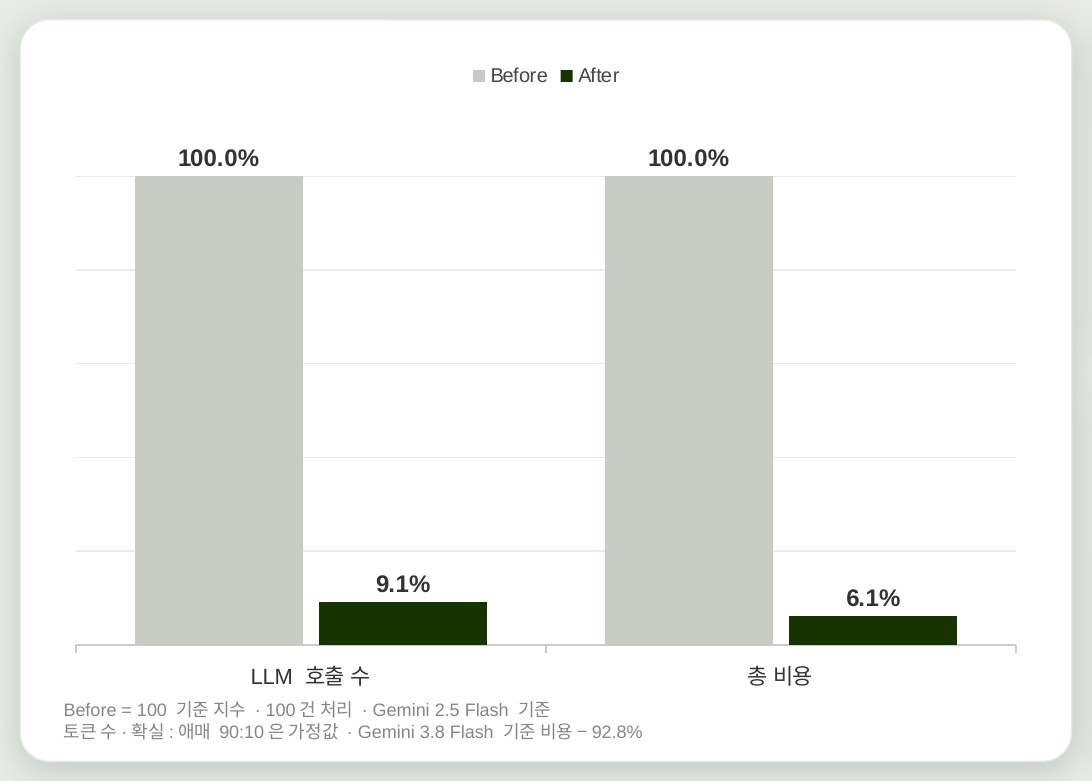
Before를 100으로 둔 지수입니다. 호출은 90.9% 비용은 93.9% 줄었습니다
배운 점
구조는 더하는 것보다 덜어내는 것이 어렵습니다. 처음에는 노드가 많을수록 에이전트다운 설계라고 생각했습니다. 하지만 각 노드에 "여기에 LLM이 꼭 필요한가"를 물어보니 대부분은 필요 없었습니다.
모든 판단을 모델에 맡길 필요는 없습니다. confidence 임계값을 다듬는 것보다 사용자에게 한 번 묻는 편이 더 정확하고 비용도 적었습니다.
환각을 검증하는 것보다 생기지 않게 하는 편이 낫습니다. 생성 후 judge로 걸러내는 구조보다 규정 원문을 그대로 돌려주는 구조가 단순하고 안전했습니다.
남은 과제
- 지원 범위: 지역 예외 데이터는 아직 경기도만 들어가 있습니다. 서울은 전국 기준으로 안내하고 있습니다.
- judge 루프 다시 연결: 응답 속도를 확보한 뒤 재분류 검증과 재시도 루프를 다시 켤 계획입니다.
- 규정 갱신: 규정이 바뀌면 지금은 수동으로 다시 색인해야 합니다.
- GraphRAG: 품목-재질-처리 방법의 관계를 그래프로 만들어 여러 재질이 섞인 제품을 나눠서 안내해 보려 합니다.
- 피드백 활용: 사용자가 고른 Top-K 후보와 "없음" 응답을 모으고 있습니다. 이 데이터로 후보 순위와 라우팅을 개선할 수 있을 것 같습니다.
코드는 GitHub 저장소에서 볼 수 있습니다.